
Les World Models : vers une intelligence de l’abstraction et du réel
Et si l’IA cessait de reconstruire le monde pixel par pixel pour enfin en comprendre la structure ? Philippe du Jardin (EDHEC) explore comment les World Models, de la conduite autonome à l’imagerie médicale, ouvrent la voie à des systèmes plus robustes, capables de relier perception, anticipation, raisonnement et action.

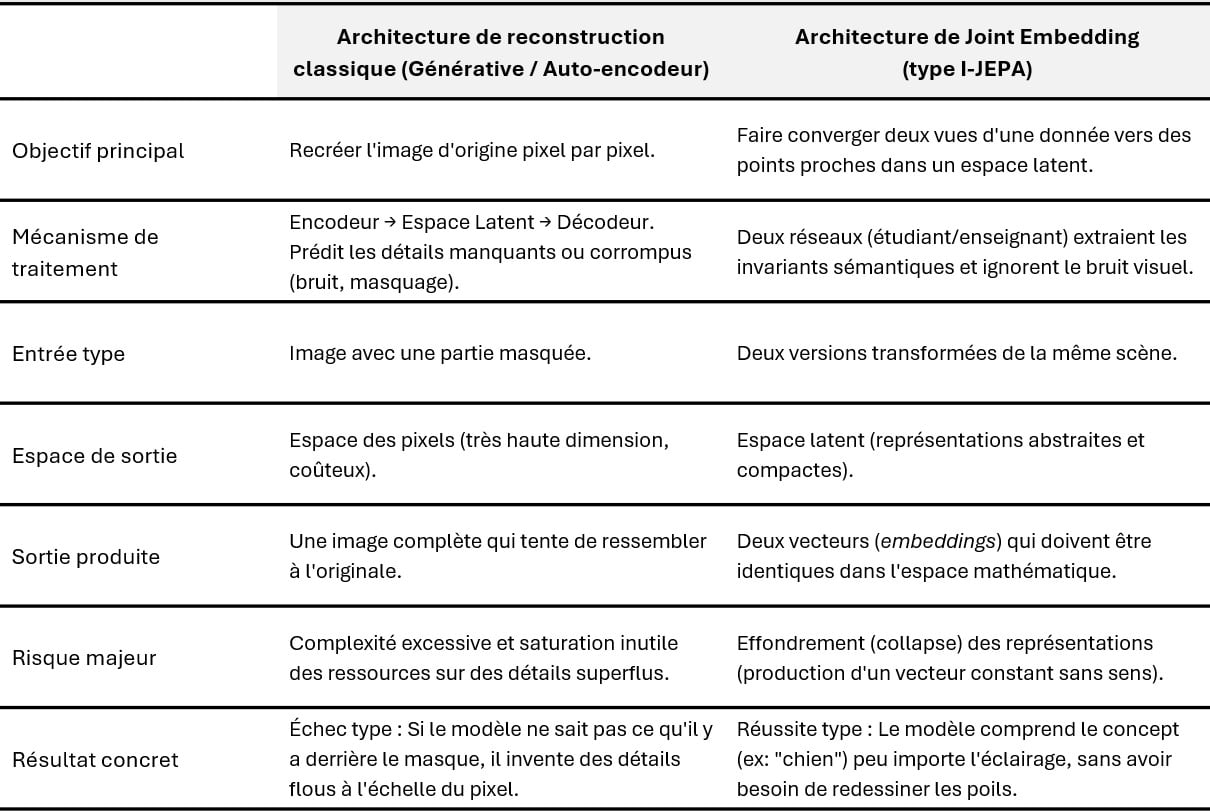
Pendant longtemps une partie de l’intelligence artificielle appliquée à la vision a reposé sur une idée simple : pour prouver qu’un système comprenait une image, il devait être capable de la reconstruire. Cette logique révèle pourtant vite ses limites. Reconstruire une scène pixel par pixel oblige le modèle à traiter une masse immense de détails parfois secondaires. Or, lorsqu’un être humain observe une rue animée, il ne mémorise pas la position exacte de chaque feuille, le reflet du soleil sur une carrosserie ou le mouvement de chaque brin d’herbe. Il identifie aussitôt les véhicules, les piétons, les obstacles et les trajectoires possibles.
C’est à partir de cette idée qu’émergent les World Models et les architectures fondées sur le joint embedding (1). Le but n’est plus de reproduire le monde dans son apparence immédiate, mais d’en apprendre la structure utile. En projetant les données dans un espace latent, le système ne s’attache plus à la surface des choses, il tente d’en extraire les régularités profondes, celles qui résistent aux changements d’angle, de lumière ou de bruit.
Dans cet article, Philippe du Jardin, Professeur à l’EDHEC, explique comment les World Models renouvellent la vision artificielle en apprenant la structure utile du monde dans un espace latent, plutôt qu’en reconstruisant les images pixel par pixel. Il montre en quoi cette abstraction rend les systèmes plus robustes et plus efficaces, de la conduite autonome à l’imagerie médicale et à la robotique, puis dresse la carte des acteurs qui portent ce mouvement : grands laboratoires (Google DeepMind, Meta), startups fondées par des figures académiques (World Labs de Fei-Fei Li, AMI de Yann LeCun) et spécialistes d’applications sectorielles (NVIDIA, PrimalVerse).
Il interroge enfin les limites de l’approche : comment éviter l’effondrement des représentations, comment intégrer l’incertitude du réel, et comment dépasser les simples régularités statistiques pour atteindre une compréhension causale du monde, capable d’articuler perception, anticipation, raisonnement et action ?
Du visible à l’essentiel
Dans ce paradigme des World Models, deux vues différentes d’une même réalité doivent conduire à des représentations proches. Une image recadrée et la même image légèrement éclaircie, par exemple, ne sont pas identiques à l’échelle des pixels, mais elles renvoient au même objet, à la même scène, au même contenu. Le modèle apprend donc à reconnaître ce qui demeure invariant après transformations (2). Il saisit qu’un chien reste un chien sous un nouvel éclairage, qu’une route reste une route même partiellement masquée, et qu’une scène conserve son identité au-delà de ses variations superficielles.
Cette manière d’apprendre présente un avantage considérable. Au lieu de mobiliser ses ressources pour reconstituer chaque détail, le modèle concentre sa capacité sur ce qui est réellement discriminant. Il devient plus sobre, plus robuste et, souvent, plus efficace qu’il ne pouvait l’être auparavant. En ce sens, il se rapproche de notre propre manière de percevoir : nous ne reconstruisons pas le monde, nous en retenons la structure.
Le piège de l’uniformité
Mais cette abstraction a un revers. Si rien ne pousse le système à distinguer les données, il peut adopter une solution trop simple : attribuer presque la même représentation à toutes les entrées. Dans ce cas, il ne différencie plus un chat d’un avion, ni une rue d’un paysage. Techniquement, la contrainte semble respectée ; intellectuellement, le résultat est vide.
Pour éviter cet effondrement des représentations, les architectures modernes imposent des mécanismes qui maintiennent une diversité suffisante dans l’espace latent (2). L’objectif est clair : des éléments semblables doivent produire des représentations proches, mais des éléments différents doivent rester séparés. Il faut donc construire un espace organisé, riche et informatif, capable de refléter la variété réelle du monde sans sombrer dans une solution uniforme.
L’incertitude comme donnée centrale
A la difficulté précédente s’en ajoute une autre : la prise en compte de l’incertitude. Dans le monde réel, une même situation peut conduire à plusieurs évolutions plausibles. Si un joueur de football s’apprête à frapper dans un ballon, il est impossible de prédire avec exactitude la trajectoire finale de la balle, les réactions des autres joueurs ou même la dynamique précise de l’instant suivant. Un bon modèle ne doit donc pas chercher une réponse unique et figée ; il doit apprendre à représenter un ensemble de possibilités (3).
C’est ici que les World Models prennent toute leur importance. Ils ne se contentent pas de reconnaître ce qui est présent ; ils cherchent à anticiper ce qui peut advenir. Une telle capacité de projection est essentielle pour la planification, la décision et l’action dans un environnement changeant. Elle permet de passer d’une simple perception statique à une compréhension orientée vers le futur.
Des applications concrètes
Cette logique devient particulièrement parlante lorsqu’on l’applique à des cas réels. En conduite autonome, par exemple, un système ne doit pas s’attarder à chaque détail visuel de la scène, mais comprendre la structure de la route, la position des autres véhicules et les dangers potentiels. Un brouillard épais, un fort éblouissement ou une visibilité réduite ne doivent pas le désorienter : il doit continuer à extraire l’essentiel de l’environnement pour anticiper la trajectoire la plus sûre (3).
Dans le domaine de l’imagerie médicale, la même exigence s’impose. Le modèle doit distinguer des structures pathologiques persistantes malgré le bruit, les artefacts techniques ou les variations de qualité d’acquisition. L’enjeu n’est pas de reproduire l’image avec perfection, mais d’identifier les invariants sémantiques utiles au diagnostic. Ici encore, la représentation latente vaut davantage que la fidélité visuelle brute.
La robotique de précision offre un autre terrain d’application. Un bras articulé qui manipule un objet déformable, ou qui évolue dans un environnement non structuré, doit comprendre les relations entre ses actions et les réactions du monde. Il ne lui suffit pas de voir ; il doit anticiper. La perception, le mouvement et la physique doivent se répondre dans un même cadre de représentation.
La multimodalité renforce encore cette capacité. Lorsqu’un système combine la vision, le son, le texte et la proprioception, il dispose d’une compréhension complète de son environnement. Si un robot entend un objet tomber au moment où sa main le frôle, même sans le voir directement, il peut utiliser cet indice pour estimer sa nouvelle position. La cohérence de la perception se renforce et elle se rapproche de celle d’une expérience du monde.
L’abstraction comme robustesse
L’un des grands intérêts des représentations latentes réside dans leur robustesse. En s’éloignant du bruit brut des pixels, la sensibilité aux perturbations superficielles du modèle diminue comme les variations d’éclairage, les ombres, le flou, les occlusions partielles ou les changements de texture. Il peut alors reconnaître une scène malgré des conditions imparfaites, là où une approche trop attachée aux détails échouerait (4).
Cette robustesse est décisive dans des contextes où les données sont rarement idéales. Un véhicule autonome, un système d’aide au diagnostic ou un robot mobile doivent tous fonctionner à partir d’indices incomplets, parfois dégradés, souvent ambigus. L’enjeu n’est donc pas de tout voir, mais de mieux comprendre ce qui compte réellement.
Le rôle des modèles fondés sur l’énergie
Les modèles fondés sur l’énergie proposent une autre manière d’organiser ces représentations. L’idée est simple : à une configuration cohérente, le modèle associe une énergie faible ; à une configuration incohérente, une énergie élevée. Le système apprend alors à creuser des vallées pour les relations plausibles et à maintenir des zones élevées pour les relations incompatibles entre elles (1).
Cette perspective est intéressante parce qu’elle donne une forme structurée à l’apprentissage. Plutôt que de produire une réponse brute, le modèle évalue la compatibilité entre différentes hypothèses. Il peut ainsi favoriser les scénarios qui s’accordent le mieux entre eux et écarter ceux qui violent les régularités apprises. Un tel cadre devient particulièrement puissant lorsqu’il s’inscrit dans un apprentissage partiellement ou totalement non supervisé.
Entre intuition physique et logique abstraite
Malgré les avancées récentes, une limite demeure : les modèles savent exploiter les régularités statistiques, mais ils ne disposent pas nécessairement d’une compréhension causale profonde du monde. Ils peuvent reconnaître qu’un objet est une tasse, sans pour autant intégrer spontanément ce que cela implique en termes de gravité, de stabilité ou d’interaction physique.
Le défi consiste donc à rapprocher deux formes d’intelligence. D’un côté, une intuition physique, capable d’anticiper le comportement du monde concret. De l’autre, une logique abstraite, qui organise les concepts et les relations entre objets. Un World Model véritablement puissant devrait pouvoir articuler ces deux dimensions : percevoir, anticiper, raisonner et agir dans un même espace cohérent (1, 4).
Qui sont les acteurs des World Models ?
Les World Models ne sont pas le fait d'un seul type d'acteur. Le paysage est aujourd'hui structuré par trois cercles qui se chevauchent partiellement : les grands laboratoires industriels, les startups fondées par des figures académiques de premier plan, et un ensemble de nouveaux entrants spécialisés sur des applications verticales.
Les grands laboratoires de recherche
Google DeepMind a été l'un des premiers à formaliser cette approche avec des systèmes comme Genie 3, capable de concevoir des environnements virtuels interactifs à partir de simples prompts textuels, et SIMA 2, orienté vers l'entraînement d'agents dans des mondes simulés. Meta, de son côté, a développé la famille V-JEPA, dont la version 2 explore l'utilisation de modèles vidéo auto-supervisés pour la compréhension, la prédiction et la planification, notamment en robotique. Ces acteurs disposent d'une puissance de calcul et de données qui leur permet d'explorer des architectures à grande échelle.
Les startups issues du monde académique
C'est sans doute le développement le plus remarquable de ces dernières années. Fei-Fei Li, professeure à Stanford et figure centrale de la vision par ordinateur, a fondé World Labs (4), qui a déjà commercialisé Marble, un modèle capable de créer des environnements 3D navigables et persistants à partir de textes ou d'images. Yann LeCun, lauréat du prix Turing et figure de proue du Deep Learning, a quitté Meta fin 2025 pour fonder AMI (Advanced Machine Intelligence), avec une levée de fonds record de plus d'un milliard de dollars pour développer des World Models fondés sur l'architecture JEPA. D'autres startups comme Runway et Odyssey explorent des voies complémentaires, notamment autour de la génération de scènes interactives et de la simulation pour la création de contenu.
Les acteurs des applications verticales
Un troisième cercle se dessine autour d'applications sectorielles. En robotique, NVIDIA a constitué une équipe spécialisée dans les World Models avec Cosmos. Dans le domaine médical, des entreprises comme PrimalVerse développent des modèles 4D pour la chirurgie assistée et le diagnostic. xAI, la société d'Elon Musk, a également annoncé des initiatives dans cette direction pour la robotique et la compréhension du monde physique.
Une future génération d’acteurs en gestation
Il serait réducteur de présenter les World Models comme une simple évolution incrémentale des acteurs de l'IA générative.
Du côté des acteurs existants, plusieurs géants de la tech ont intégré les World Models dans leur feuille de route, mais avec des degrés de priorité très variables. Google DeepMind en a fait un axe de recherche majeur, en parallèle de ses travaux sur les grands modèles de langage. Meta, bien que fortement engagé dans les LLM, a continué à financer des recherches sur JEPA, même si l'orientation stratégique de l'entreprise a suscité des tensions internes, comme l'illustre le départ de LeCun. OpenAI a également évoqué la piste des modèles vidéo comme voie d'accès aux World Models, sans en faire pour l'instant une priorité affichée.
Ce qui est véritablement nouveau, en revanche, c'est l'émergence d'un écosystème de startups spécialisées dans les World Models, dont les fondateurs sont souvent issus de la recherche académique et qui se positionnent explicitement en rupture avec le paradigme dominant des LLM. LeCun lui-même a qualifié les grands modèles de langage d'« artisans du texte dans l'obscurité », soulignant leur incapacité à comprendre le monde physique. Fei-Fei Li a de son côté avancé que « le langage ne capture qu'un sous-ensemble de la connaissance humaine », et que la cognition est fondamentalement multimodale.
Il faut donc distinguer deux dynamiques. D'un côté, des acteurs établis qui ajoutent les World Models à leur portefeuille technologique, souvent pour améliorer leurs systèmes existants (vidéo, robotique, simulation). De l'autre, une nouvelle génération d'acteurs qui se définissent par les World Models et qui considèrent cette approche non pas comme un complément, mais comme le chemin principal vers une intelligence artificielle véritablement générale. Entre ces deux pôles, une troisième voie se dessine : celle d'acteurs spécialisés sur des applications verticales (santé, industrie, défense) pour lesquels la robustesse et la capacité d'anticipation des World Models représentent un avantage compétitif immédiat.
Conclusion
Les World Models marquent une évolution importante dans la manière de penser l’intelligence artificielle. Ils déplacent l’objectif de la simple reconstruction vers la compréhension des structures utiles, des relations stables et des évolutions possibles (5). En apprenant à représenter le monde dans un espace latent, ils gagnent en robustesse, en efficacité et en capacité de projection.
Une telle approche ne résout pas tout. Elle soulève encore des questions sur l’incertitude, la causalité, la généralisation et la nature même de la compréhension. Pour autant, elle ouvre une voie prometteuse : celle d’une intelligence qui ne se contente pas de voir, mais qui commence à organiser le réel pour mieux y agir.
Références
(1) LeCun, Y. (2022). A Path Towards Autonomous Machine Intelligence. OpenReview - https://openreview.net/challenge?redirect=%2Fpdf%3Fid%3DBZ5a1r-kVsf
(2) Balestriero, R., & LeCun, Y. (2025). LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics. NeurIPS 2025. - https://www.researchgate.net/publication/397522456_LeJEPA_Provable_and_Scalable_Self-Supervised_Learning_Without_the_Heuristics
(3) Assran, M., Bardes, A., Fan, D., et al. (2025). V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv:2506.09985. - https://www.researchgate.net/publication/392597575_V-JEPA_2_Self-Supervised_Video_Models_Enable_Understanding_Prediction_and_Planning
(4) Li, F.-F. (2025). From Words to Worlds: Spatial Intelligence is the Next Frontier of AI. Substack / World Labs - https://fr.scribd.com/document/953026801/From-Words-to-Worlds-Spatial-Intelligence-is-AI-s-Next-Frontier
(5) Ghaemi, H., Muller, E. B., & Bakhtiari, S. (2025). seq-JEPA: Autoregressive Predictive Learning of Invariant-Equivariant World Models. NeurIPS 2025 - https://neurips.cc/virtual/2024/104556


